Cashcrown // analiza dokumentów · 08/11
Doc Intelligence
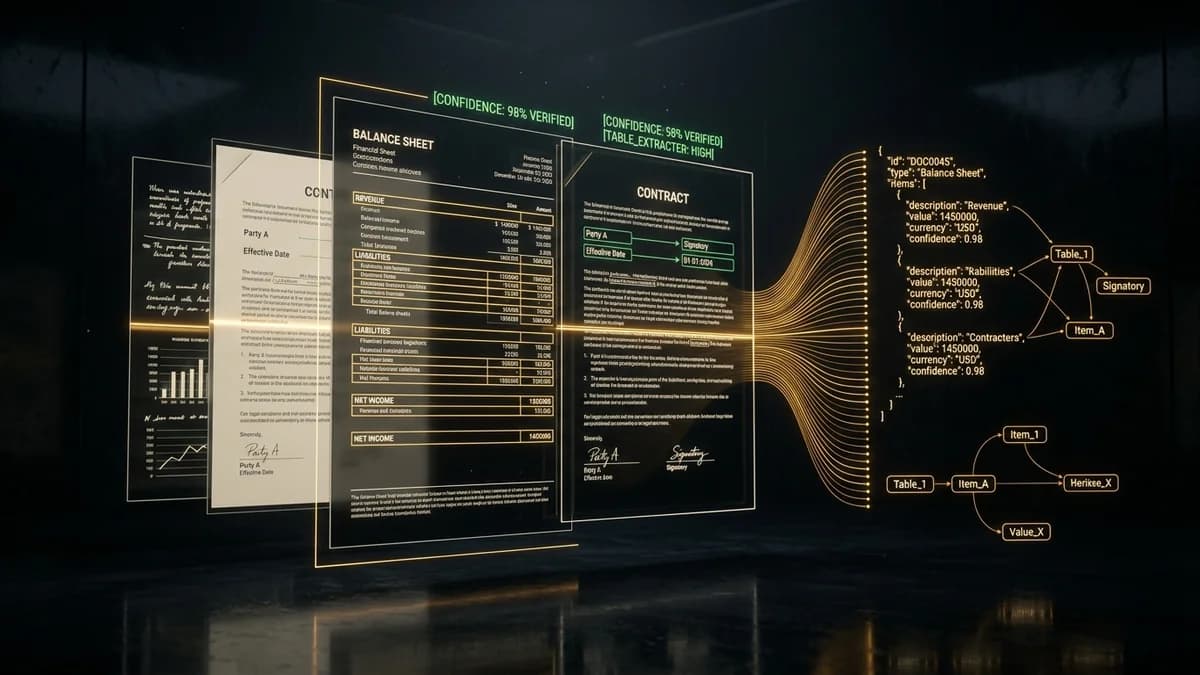
doc-intellivePipeline, który zamienia bałaganiarskie dokumenty: PDF-y, skany, zdjęcia, DOCX, w ustrukturyzowane, weryfikowalne dane: każde pole z odnośnikiem do źródła i progiem pewności.
self-host
deploy
zero-retention
dane
4 tryby
źródła wejścia
per-pole
pewność
01
Problem
Dane z dokumentów przepisuje się ręcznie albo wyciąga gotowym OCR, który nie mówi, czy się pomylił. Pole bez źródła i bez progu pewności trafia do systemu bez kontroli, a pojedynczy błąd w skanie kosztuje godziny korekt, albo ciche nadpisanie ważnej wartości.
02
Możliwości
- OCR z poziomem pewności per pole i per znak
- klasyfikacja typu dokumentu i ekstrakcja pól
- każde pole z odnośnikiem do fragmentu źródłowego
- pola niskiej pewności trafiają do przeglądu człowieka
- krytyczne pola nigdy nie nadpisują się automatycznie
03
Zakres wdrożenia
- Wielomodelowy pipeline OCR i wizyjny dla dokumentów (PDF, DOCX, skany, zdjęcia) z pewnością per znak
- Automatyczna klasyfikacja typów dokumentów i precyzyjna ekstrakcja tabel, nagłówków oraz klauzul
- Każde wyekstrahowane pole powiązane z wizualnym fragmentem źródłowym dla błyskawicznej weryfikacji
- Kolejkowanie pól niskiej pewności do weryfikacji przez człowieka bez ryzyka cichego nadpisania danych
Ten produkt składamy z mierzonych modeli i komponentów - zobacz pełny pipeline na żywo:
04
Pilotaż z dowodami
Pakiet pilotażowy: ekstrakcja dokumentów z dowodem źródłowym
Doc Intelligence wdrażamy dla krytycznych procesów back-office: każdy dokument otrzymuje precyzyjną strukturę pól, bounding box na skanie i próg pewności eliminujący halucynacje.
>99.2%
dokładność ekstrakcji pól
100%
pól z linkiem do źródła
0
cichych nadpisań w CRM/ERP
Dowody
Playground: interaktywny analizator dokumentów
Przetestuj ekstrakcję danych ze złożonych dokumentów i sprawdź wizualne mapowanie pól w czasie rzeczywistym.
zobacz dowódAudytowalność i niezmienność dowodów
Zasady przechowywania skanów, sum kontrolnych SHA-256 oraz rejestracji decyzji operatora w systemie.
zobacz dowódŚcieżka pilotażu
- 01Krok 1: Dobór reprezentatywnej próby 50 dokumentów (umowy, faktury, protokoły) i definicja schematu pól
- 02Krok 2: Konfiguracja wieloetapowego OCR, modeli wizyjnych i kolejki human-in-the-loop dla pól wątpliwych
- 03Krok 3: Integracja webhooków z systemem ERP/CRM i raport z walidacji wskaźników dokładności
05
Integracje
routerBGE-M3QdrantOllaman8nFastAPI
06
Architektura
Wybierz węzeł, aby zobaczyć opis i przepływ danych.
Architektura - opis tekstowy
- Wejście / dane
- Źródła danych: Treści, dokumenty i zdarzenia trafiają do indeksu. (Przepływ do: BGE-M3)
- BGE-M3: Lokalne embeddingi (1024-dim) - PII zostaje na miejscu. (Przepływ do: Router OpenClaw)
- Rdzeń AI
- Router OpenClaw: Jedyne wejście do modeli - maskuje PII, dobiera model, limituje. (Przepływ do: Doc Intelligence)
- Doc Intelligence: Pipeline, który zamienia bałaganiarskie dokumenty: PDF-y, skany, zdjęcia, DOCX, w ustrukturyzowane, weryfikowalne dane: każde pole z odnośnikiem do źródła i progiem pewności. (Przepływ do: API)
- Wyjście / integracje
- API: Powierzchnia REST - odpowiedzi z cytatami i kontrolą dostępu. (Przepływ do: router, BGE-M3, Qdrant, Ollama)
- router: Integracja: router.
- BGE-M3: Integracja: BGE-M3.
- Qdrant: Integracja: Qdrant.
- Ollama: Integracja: Ollama.
07
Demo na żywo
08
FAQ
Ile kosztuje, jak liczycie zwrot i jaką macie skuteczność?
Pracujemy w przedziałach zależnych od zakresu: zaczynamy od pilotażu o stałym koszcie na Waszej próbce dokumentów, żebyś zobaczył realną skuteczność przed większą inwestycją. Skuteczność podajemy widełkami zależnymi od jakości źródła: czyste PDF-y cyfrowe zwykle 95–99% pól, dobre skany 90–97%, zdjęcia i słabe skany 80–92%: dlatego pola niskiej pewności i tak trafiają do przeglądu. Gdy pipeline odbiera kilkanaście–kilkadziesiąt godzin przepisywania miesięcznie, zwykle zwraca się w 2–4 miesiące. Zwrot policzysz w kalkulatorze ROI.
Czy integruje się z naszymi systemami i jest zgodne z RODO?
Tak. Wyniki oddajemy przez API i webhooki (n8n), wpinamy się w Wasz obieg dokumentów i CRM, a akcje nieodwracalne (w tym nadpisanie krytycznego pola) wymagają potwierdzenia człowieka (human-gate). Pipeline jest self-hosted i działa w trybie zero-retention: dokumenty z PII przetwarzamy lokalnie, nic nie zostaje po przetworzeniu, a zgodność z RODO i AI Act projektujemy od początku.
Od czego zacząć i jakie dokumenty obsłużycie?
Zaczynamy od jednego typu dokumentu i kilkudziesięciu Waszych prawdziwych przykładów: to wystarczy, żeby zmierzyć skuteczność i ustawić progi pewności. Obsługujemy cztery tryby wejścia: PDF-y cyfrowe, skany, zdjęcia i DOCX (faktury, umowy, formularze, protokoły). Po pilotażu rozszerzamy o kolejne typy i pola. Nie obiecujemy 100% automatyzacji: celem jest pewna ekstrakcja tam, gdzie model jest pewny, i przegląd człowieka tam, gdzie nie jest.
doc-intel · Docker / Kubernetes (On-Premises, Air-Gapped lub prywatny VPC w UE)
Executive Brief 1-Pager (Podsumowanie dla Zarządu i Procurement)
Dane z dokumentów przepisuje się ręcznie albo wyciąga gotowym OCR, który nie mówi, czy się pomylił. Pole bez źródła i bez progu pewności trafia do systemu bez kontroli, a pojedynczy błąd w skanie kosztuje godziny korekt, albo ciche nadpisanie ważnej wartości.
deploy: self-hostdane: zero-retentionźródła wejścia: 4 trybypewność: per-pole
Docelowe integracje:routerBGE-M3QdrantOllaman8nFastAPI
→Powiązane