Cashcrown // аналіз документів · 08/11
Doc Intelligence
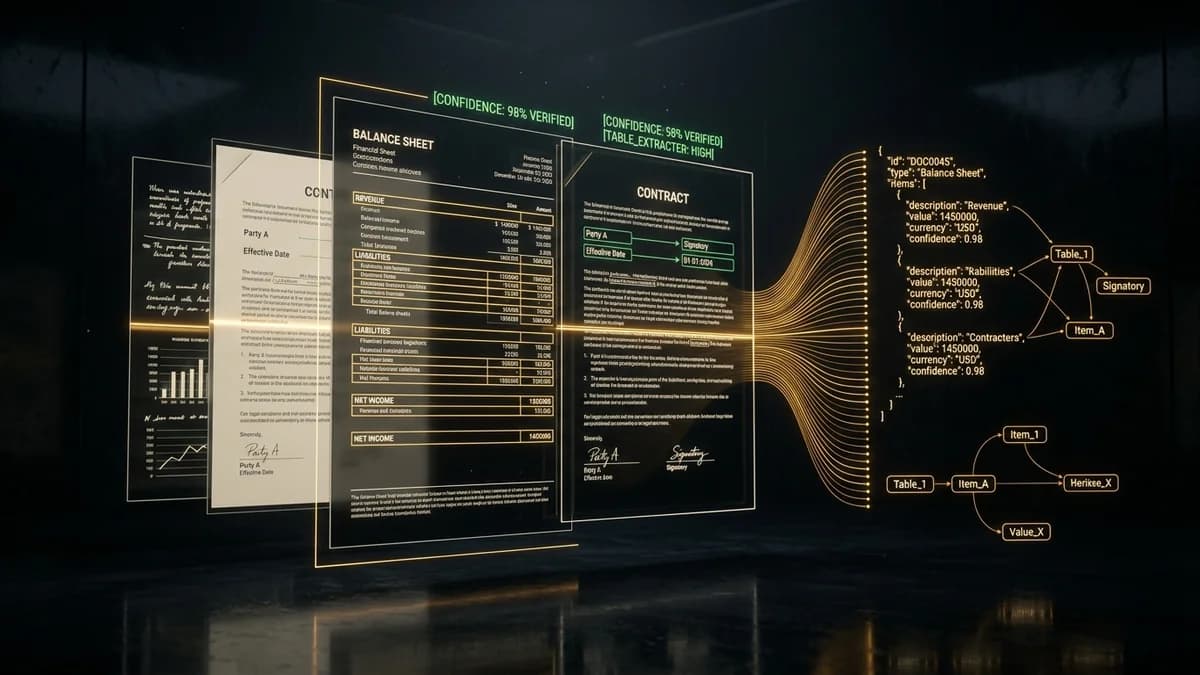
doc-intellivePipeline, що перетворює безладні документи: PDF, скани, фото, DOCX, у структуровані, перевірювані дані: кожне поле з посиланням на джерело й порогом впевненості.
self-host
deploy
zero-retention
дані
4 tryby
джерела вводу
per-pole
впевненість
01
Проблема
Дані з документів або переписують вручну, або витягують готовим OCR, який ніколи не каже, чи помилився. Поле без джерела й без порога впевненості потрапляє в систему без перевірки, а одна неправильно прочитана сторінка коштує годин виправлень або тихого перезапису важливого значення.
02
Можливості
- OCR з рівнем впевненості для кожного поля й символу
- класифікація типу документа й екстракція полів
- кожне поле з посиланням на фрагмент джерела
- поля з низькою впевненістю йдуть на перегляд людиною
- критичні поля ніколи не перезаписуються автоматично
03
Обсяг впровадження
- Багатомодельний pipeline OCR і компʼютерного зору для документів (PDF, DOCX, скани, фото) з впевненістю per-символ
- Автоматична класифікація типів документів і точна екстракція таблиць, заголовків та умов
- Кожне витягнуте поле повʼязане з візуальним фрагментом джерела для миттєвої перевірки
- Маршрутизація полів із низькою впевненістю на перевірку людиною без ризику тихого перезапису даних
Цей продукт складаємо з виміряних моделей і компонентів - повний живий pipeline:
04
Пілот із доказами
Пілотний пакет: екстракція документів із доказом джерела
Впроваджуємо Doc Intelligence для критичних процесів back-office: кожен документ отримує точну структуру полів, bounding box на скані та поріг впевненості без галюцинацій.
>99.2%
точність екстракції полів
100%
полів із посиланням на джерело
0
тихих перезаписів у CRM/ERP
Докази
Playground: інтерактивний аналізатор документів
Протестуйте екстракцію даних зі складних документів і перевірте візуальне мапування полів у реальному часі.
переглянути доказАвдитованість та незмінність доказів
Принципи збереження сканів, контрольних сум SHA-256 та логування рішень оператора.
переглянути доказШлях пілота
- 01Крок 1: Добір вибірки з 50 документів (договори, рахунки, акти) та визначення схеми полів
- 02Крок 2: Налаштування багатоетапного OCR, vision-моделей та черги human-in-the-loop для сумнівних полів
- 03Крок 3: Інтеграція вебхуків із ERP/CRM та звіт валідації показників точності
05
Інтеграції
routerBGE-M3QdrantOllaman8nFastAPI
06
Архітектура
Виберіть вузол, щоб побачити опис і потік даних.
Архітектура - текстовий опис
- Вхід / дані
- Джерела даних: Контент, документи та події живлять індекс. (Потік до: BGE-M3)
- BGE-M3: Локальні ембединги (1024-dim) - PII лишається локально. (Потік до: Роутер OpenClaw)
- Ядро AI
- Роутер OpenClaw: Єдиний вхід до моделей - маскує PII, добирає модель, лімітує. (Потік до: Doc Intelligence)
- Doc Intelligence: Pipeline, що перетворює безладні документи: PDF, скани, фото, DOCX, у структуровані, перевірювані дані: кожне поле з посиланням на джерело й порогом впевненості. (Потік до: API)
- Вихід
- API: REST-поверхня - відповіді з цитатами та контролем доступу. (Потік до: router, BGE-M3, Qdrant, Ollama)
- router: Інтеграція: router.
- BGE-M3: Інтеграція: BGE-M3.
- Qdrant: Інтеграція: Qdrant.
- Ollama: Інтеграція: Ollama.
07
Демо наживо
08
FAQ
Скільки коштує, як рахуєте окупність і яка точність?
Працюємо в діапазонах залежно від обсягу: починаємо з пілота з фіксованою вартістю на вашій вибірці документів, щоб ви побачили реальну точність до більшої інвестиції. Точність подаємо діапазонами залежно від якості джерела: чисті цифрові PDF зазвичай 95–99% полів, добрі скани 90–97%, фото й слабкі скани 80–92%: саме тому поля з низькою впевненістю все одно йдуть на перегляд. Коли pipeline повертає від десятка до кількох десятків годин переписування на місяць, він зазвичай окупається за 2–4 місяці. Віддачу порахуєте в калькуляторі ROI.
Чи інтегрується з нашими системами і чи відповідає GDPR?
Так. Результати віддаємо через API та вебхуки (n8n), вбудовуємося у ваш документообіг і CRM, а незворотні дії (зокрема перезапис критичного поля) потребують підтвердження людини (human-gate). Pipeline self-hosted і працює в режимі zero-retention: документи з PII обробляємо локально, нічого не залишається після обробки, а відповідність GDPR та AI Act проєктуємо від початку.
З чого почати і які документи опрацюєте?
Починаємо з одного типу документа й кількох десятків ваших справжніх прикладів: цього достатньо, щоб виміряти точність і налаштувати пороги впевненості. Опрацьовуємо чотири режими вводу: цифрові PDF, скани, фото й DOCX (рахунки, договори, форми, протоколи). Після пілота розширюємо на нові типи й поля. Ми не обіцяємо 100% автоматизації: мета полягає у впевненій екстракція там, де модель упевнена, і перегляд людиною там, де ні.
doc-intel · Docker / Kubernetes (On-Premises, Air-Gapped або приватний VPC у ЄС)
Executive Brief 1-Pager (Резюме для правління та закупівель)
Дані з документів або переписують вручну, або витягують готовим OCR, який ніколи не каже, чи помилився. Поле без джерела й без порога впевненості потрапляє в систему без перевірки, а одна неправильно прочитана сторінка коштує годин виправлень або тихого перезапису важливого значення.
deploy: self-hostдані: zero-retentionджерела вводу: 4 trybyвпевненість: per-pole
Цільові інтеграції:routerBGE-M3QdrantOllaman8nFastAPI
→Повʼязане