Cashcrown // ai quality evaluation · 09/11
Eval Harness
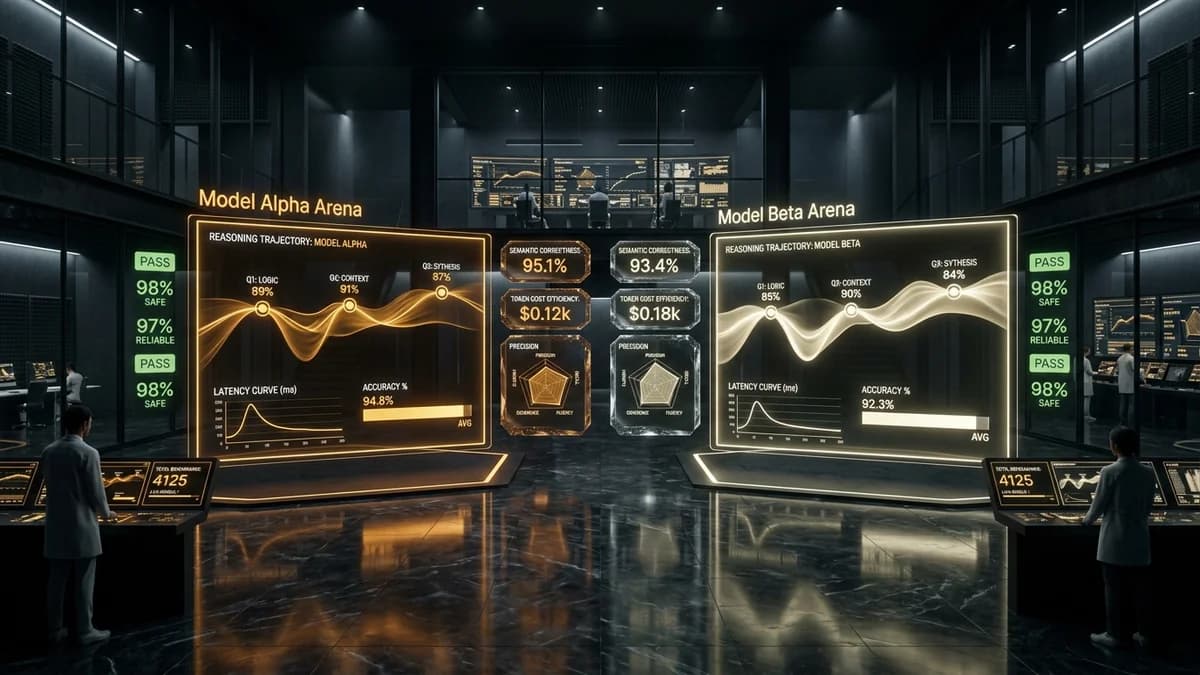
eval-harnessliveEin Evaluations-Harness für LLM-/RAG-Systeme: ein Golden Set, automatische Metriken, ein an menschlichen Labels kalibrierter LLM-as-Judge und ein Regressions-Gate, das ein Deployment bei Qualitätsabfall blockiert.
4 tryby
Metrik-Modi
self-host
Deployment
zero-retention
Daten
CI gate
Regression
01
Problem
Ohne Evaluation wissen Sie nicht, ob ein neuer Prompt, ein neues Modell oder eine RAG-Änderung die Qualität verbessert oder still beschädigt hat. Antworten „mit dem Auge" zu prüfen skaliert nicht und fängt Regressionen nicht ab, bevor sie den Kunden erreichen.
02
Funktionen
- ein Golden Set von Testfällen mit Erwartungen
- automatische Metriken: Precision/Recall/F1, Faithfulness, Zitierungen
- ein an menschlichen Labels kalibrierter LLM-as-Judge
- ein Regressions-Gate, das das Deployment bei Qualitätsabfall blockiert
- vollständige Lauf-Historie für die Trendanalyse
03
Lieferumfang
- Ein an die Kundendomäne angepasstes Golden-Benchmark-Set mit Versionierung im Repository
- Automatische deterministische Metriken (BLEU, ROUGE, F1) kombiniert mit einem kalibrierten LLM-as-a-Judge
- Ein CI/CD-Qualitätsregressions-Gate, das Deployments bei sinkender Wiedergabetreue blockiert
- Visuelles Experiment-Vergleichs-Dashboard, Modell-Drift-Analyse und Kosten-Qualitäts-Trendberichte
Wir bauen dieses Produkt aus gemessenen Modellen und Komponenten - die vollständige Live-Pipeline:
04
Pilot mit Belegen
Pilotpaket: Evaluations-Harness und Qualitätsregressions-Gate
Wir implementieren Eval Harness, um Evaluierung nach Augenmaß zu beenden: versioniertes Golden Set, automatische Faithfulness-Metriken und ein striktes CI/CD-Gate gegen Regressionen.
100%
Golden-Set-Abdeckung
0
stille Produktionsregressionen
CI/CD
automatisches Deploy-Gate
Belege
Fallstudie: automatisierter Audit und adversarische Prüfung
Erfahren Sie, wie mehrstufige Evaluierung Fehlalarme beseitigte und reproduzierbare Benchmark-Ergebnisse sicherstellte.
Beleg ansehenReproduzierbarkeit und Test-Auditierbarkeit
Prinzipien für deterministische LLM-Judges, Testversionierung und prüfbare Benchmark-Lauflogs.
Beleg ansehenPilotpfad
- 01Schritt 1: Sammlung und Annotation von 100 zentralen Nutzeranfragen für das Golden-Dataset
- 02Schritt 2: Kalibrierung des LLM-as-a-Judge auf die Domäne und Festlegung von Faithfulness- und Zitierschnittstellen
- 03Schritt 3: Anbindung des Regressions-Gates an GitHub Actions / GitLab CI und Durchführung des ersten Audits
05
Integrationen
routerBGE-M3QdrantOllamaFastAPIn8n
06
Architektur
Knoten wählen, um Beschreibung und Datenfluss zu sehen.
Architektur - Textbeschreibung
- Eingang / Daten
- Datenquellen: Inhalte, Dokumente und Ereignisse speisen den Index. (Fluss zu: BGE-M3)
- BGE-M3: Lokale Embeddings (1024-dim) - PII bleibt lokal. (Fluss zu: OpenClaw-Router)
- KI-Kern
- OpenClaw-Router: Einziger Modellzugang - maskiert PII, wählt Modell, drosselt. (Fluss zu: Eval Harness)
- Eval Harness: Ein Evaluations-Harness für LLM-/RAG-Systeme: ein Golden Set, automatische Metriken, ein an menschlichen Labels kalibrierter LLM-as-Judge und ein Regressions-Gate, das ein Deployment bei Qualitätsabfall blockiert. (Fluss zu: API)
- Ausgabe
- API: REST-Fläche - belegte Antworten mit Zugriffskontrolle. (Fluss zu: router, BGE-M3, Qdrant, Ollama)
- router: Integration: router.
- BGE-M3: Integration: BGE-M3.
- Qdrant: Integration: Qdrant.
- Ollama: Integration: Ollama.
07
Live-Demo
08
FAQ
Was kostet es und wie läuft die Einführung ab?
Wir arbeiten in Spannen je nach Umfang: wir starten mit einem Pilot zu Festkosten, in dem wir das Golden Set und das erste Regressions-Gate aufbauen. Ein Eval rechnet sich meist schon bei der ersten Regression, die er abfängt, bevor sie den Kunden erreicht: er spart Stunden manueller Prüfung und kostspielige Ausrutscher. Die Rendite berechnen Sie im ROI-Rechner.
Lässt es sich in unser CI integrieren und ist es DSGVO-konform?
Ja. Wir führen den Harness in Ihrem CI als Gate vor dem Deployment aus: ein rotes Ergebnis blockiert das Release. Er läuft self-hosted mit Zero-Retention: Testdaten und Embeddings (BGE-M3) bleiben bei Ihnen, wir maskieren PII vor der Cloud und verarbeiten sensible Pfade lokal: DSGVO- und AI-Act-Konformität von Anfang an eingeplant.
Wo fangen wir an, und ersetzt der Eval einen Menschen?
Wir starten mit einigen Dutzend repräsentativen Fällen und ihren manuellen Labels: das ist das Golden Set, an dem wir den LLM-as-Judge kalibrieren. Ein Eval ergänzt, ersetzt aber niemals das menschliche Urteil bei Ergebnissen mit hohem Risiko: die Automatisierung fängt Regressionen ab und verfolgt den Trend, während ein Mensch die kritischen Entscheidungen trifft und das letzte Wort am Gate hat.
eval-harness · Docker / Kubernetes (On-Premises, Air-Gapped oder private EU-VPC)
Executive Brief 1-Pager (Zusammenfassung für Vorstand & Einkauf)
Ohne Evaluation wissen Sie nicht, ob ein neuer Prompt, ein neues Modell oder eine RAG-Änderung die Qualität verbessert oder still beschädigt hat. Antworten „mit dem Auge" zu prüfen skaliert nicht und fängt Regressionen nicht ab, bevor sie den Kunden erreichen.
Metrik-Modi: 4 trybyDeployment: self-hostDaten: zero-retentionRegression: CI gate
Ziel-Integrationen:routerBGE-M3QdrantOllamaFastAPIn8n
→Verwandt